Anthropic 于 2026 年 9 月 22 日发布 Claude Opus 5.5,并表示其在典型工作负载下的运行费用较 Opus 5 降低约 40%。这是厂商测试口径。企业准备升级时,应把费用和业务结果放在同一组样本中核对,不能仅依据模型名称或宣传指标。Anthropic 发布说明
企业 Agent 通常要读资料、调用工具、处理异常并交付业务结果。模型能力变化后,可能改变检索次数、补问方式和工具调用顺序。这些变化都可能影响实际费用和工作质量。
升级前的固定基线
先保存当前方案的模型配置、提示语、技能版本和工具清单,再选取已有人验收的任务作为比较基线。原始输入、附件、预期输出和允许动作应完整保留。
| 样本类型 | 核对重点 |
|---|---|
| 完整资料任务 | 结果是否准确、格式是否可用 |
| 资料不足任务 | 是否补问、是否编造缺失字段 |
| 资料冲突任务 | 是否保留冲突并说明依据 |
| 工具失败任务 | 是否识别失败并避免重复动作 |
| 多轮接续任务 | 是否延续已确认事实与执行进度 |
涉及真实业务写入的验证应放在隔离环境,或使用可明确识别的测试对象。批量创建正式单据不能作为默认测试方式。
接口兼容与历史接续
检查使用的 SDK、模型标识和参数是否受支持。发布说明中涉及推理内容保留等集成变化时,应按官方迁移文档处理,不能仅替换名称后假定旧逻辑完全兼容。
多轮任务需要保留平台要求的历史结构,避免在接续时丢失工具结果或已确认限制。可设计一个先查资料、等待补充、再完成整理的样本,核对模型是否错误地从头重做。
业务结果的逐项比较
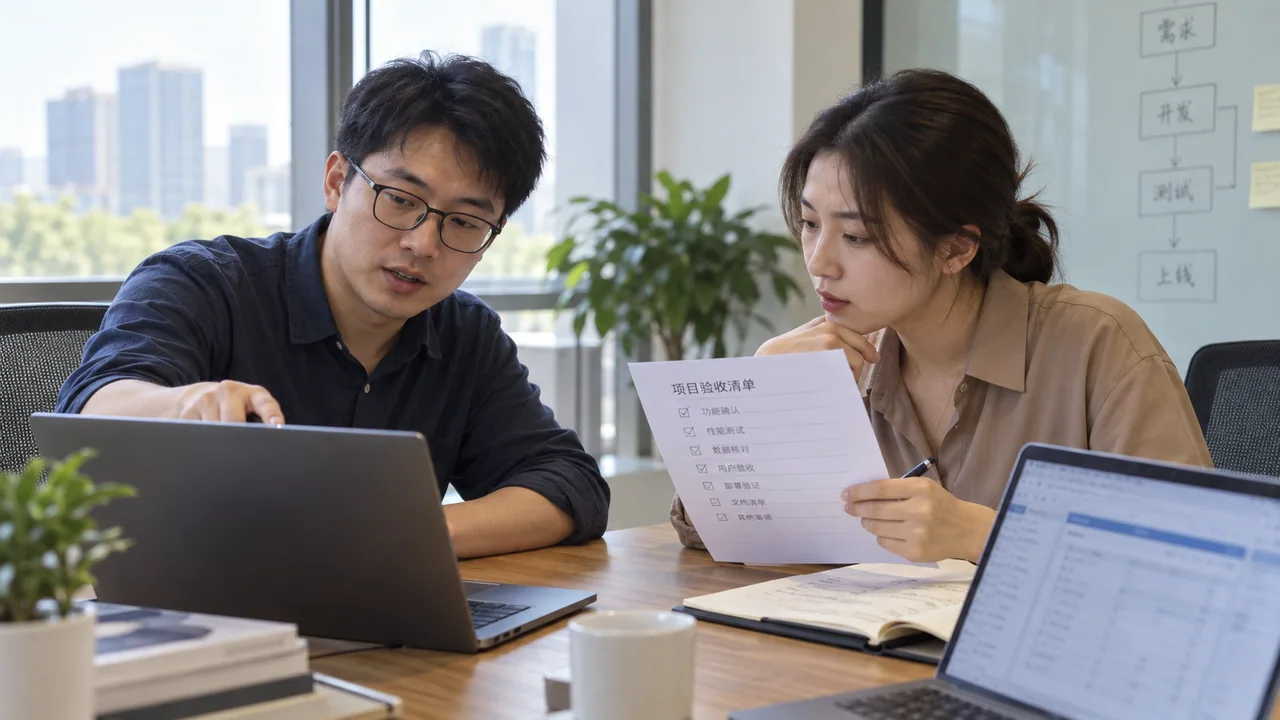
对采购比价,核对物料、单位、税费口径和不可比项;对经营分析,核对查询期间、筛选条件和引用来源;对服务工单,核对设备、问题和处理责任。不要只让另一个模型给整体评分。
结果好看但字段错位,应记录为业务错误。结果较简洁但完整满足要求,可以通过。验收者应先依据业务清单判定,再看文字风格,避免把篇幅长当成质量高。
成本和返工的合并统计
示例:两套方案分别处理同一批 50 项任务,记录每项任务全部模型与工具费用,同时记录人工修改次数、补资料次数和未完成数。50 项只是示例规模,正式样本应覆盖实际业务类型。
单价下降后,如果模型反复检索或输出过长,任务总费用可能没有同比例下降。相反,减少一次人工修正也可能比少用部分 tokens 更有意义。应分别报告模型费用和人工复核工作量,避免混成无法追溯的收益数字。
生产启用与异常恢复
升级配置应有明确版本,并保留回到已验证配置的路径。正在执行的长任务是否继续使用原模型,需要由平台策略明确;同一任务中随意切换模型,会增加定位问题的难度。
上线后跟踪失败类型、异常费用和业务改判。发现某一岗位退步时,先限定受影响任务,检查资料、工具和配置,再决定是否调整模型。这样可以区分模型变化与外部系统故障。
可结合业务验收指标和生产变更管理制定升级清单;企业 AI 落地服务可将模型回归纳入持续维护范围。