企业知识中枢可以告诉 AI 一个项目的背景、使用的流程和相关人员,但“今天还有多少待发订单”应当查询订单系统。把这两类信息混在一起,会产生一种很隐蔽的错误:回答逻辑完整、引用也存在,数据却已经过时。
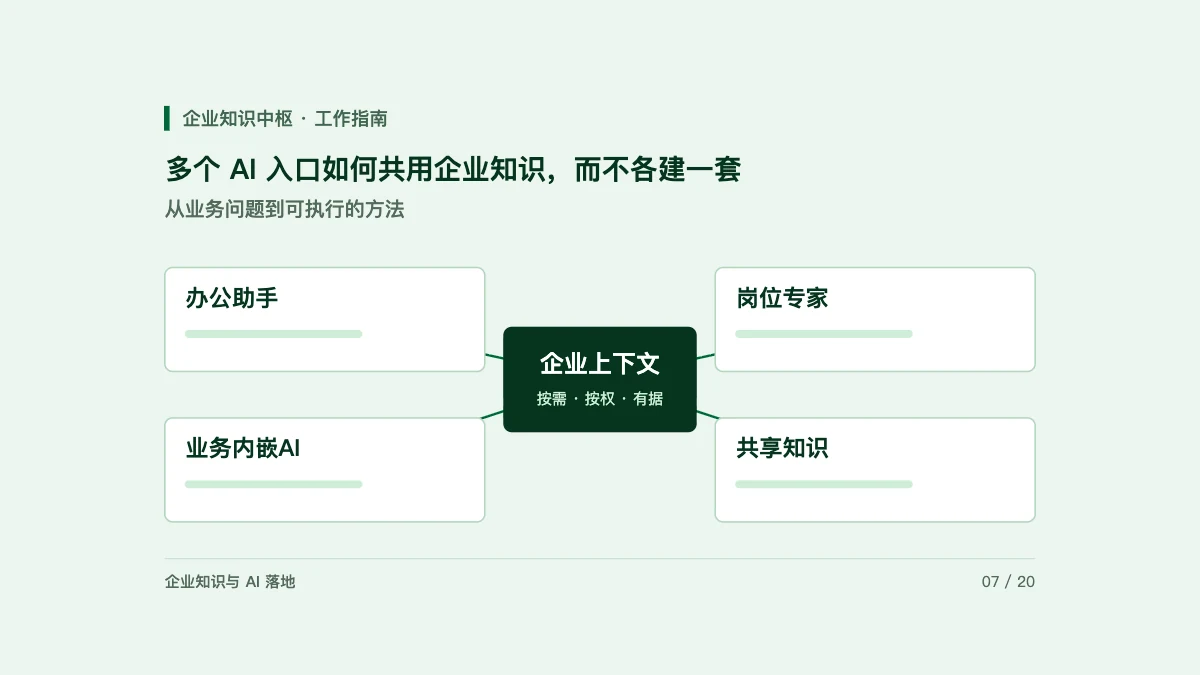
合理分工是让知识负责组织理解,让业务系统提供当前记录。AI 根据问题所需的时效决定是否回源,而不是对所有问题都使用最近一次知识整理结果。
一个更新时间不够表达信息时效
至少要区分三种时间:原始来源在什么时候形成或被观察到,规则从什么时候开始适用,知识页在什么时候被整理。它们可能相隔很久,不能相互替代。
例如,周一整理了一份上周会议纪要,纪要中的安排从下周开始执行。知识页的更新时间是周一,但不能因此说“该安排目前已经生效”。同样,系统今天重新整理了一份旧库存表,并不意味着库存数字已经更新到今天。
按问题类型确定读取路径
| 提问 | 首要信息 | 推荐路径 |
|---|---|---|
| 这项业务为什么这样做 | 决策背景与规则 | 读知识,必要时回查原文 |
| 某产品适合哪些用途 | 现行产品说明 | 读现行知识并检查版本 |
| 今天库存有多少 | 当前库存记录 | 查询业务系统 |
| 所有未完成订单有哪些 | 完整集合与状态 | 查询系统并处理分页 |
| 这批货是否可以放行 | 当前检验状态与放行规则 | 知识和系统共同核对 |
| 去年为什么调整流程 | 历史决定与当时资料 | 读取历史证据链 |
其中“所有”“当前”“合计”“截至”都是重要提示。知识检索返回相关内容,通常不负责证明一个业务集合已经完整。让搜索结果承担统计口径,很容易漏掉没有被检索到的记录。
一次任务可以同时使用两类来源
假设计划员问:“这批订单为什么有交付风险?”AI 可以先从知识了解产品齐套规则、外协环节和历史处理办法,再到 ERP 或 MES 查询当前订单、在制与物料状态。最终回答应把判断依据拆清楚:规则来自哪里,实时状态查询于何时,哪些缺口还没确认。
这也避免把历史经验误用为当前事实。过去某个供应商经常延期,可以作为需要关注的线索;本批订单是否延期,要看当前承诺与实际进度,不能直接套用旧评价。
回源失败不能静默使用旧快照
业务系统暂时无法查询时,应明确本次没有取得当前数据。已有知识可以继续用于解释流程或列出待核事项,但不能把旧库存、旧余额或旧审批状态包装成现场查询结果。
输出可以很简洁:“已找到该产品的齐套规则,当前物料状态查询未完成,暂不能确认是否可交付。”这比给一个带日期却容易被误读的确定结论更实用。对已有工作系统,可以把未完成查询交给负责人处理,并保留任务状态。
周期整理仍然有独立价值
即使能实时查数,企业仍需要定期整理业务背景和经验。系统字段常能告诉人“发生了什么”,却不一定解释“为什么调整”“这项例外适用于谁”“谁能裁定冲突”。这些上下文能减少每次任务重新阅读大量消息的负担。
更新频率应根据企业运行方式和来源能力设置,但频率更高不代表每条知识都新鲜。应检查来源是否实际读取成功、哪些对象受到影响、现行结论是否需要改写。不能用一次轮询成功代表所有来源都已刷新。
用两道不同的题检查系统
第一道题问现行制度,让 AI 给出适用范围与依据;第二道题问当前订单数量,让 AI 查询原系统并说明统计口径。再让业务方修改一条记录,重新提问,观察系统是否读到了变化。这样可以直接识别“所有问题都查文档”的实现缺口。
进一步组织上下文,可参考公司全貌建设与企业知识验收题集。知识与连接器如何配合,见企业知识中枢。
更多同主题内容见企业 AI Agent 落地专题。