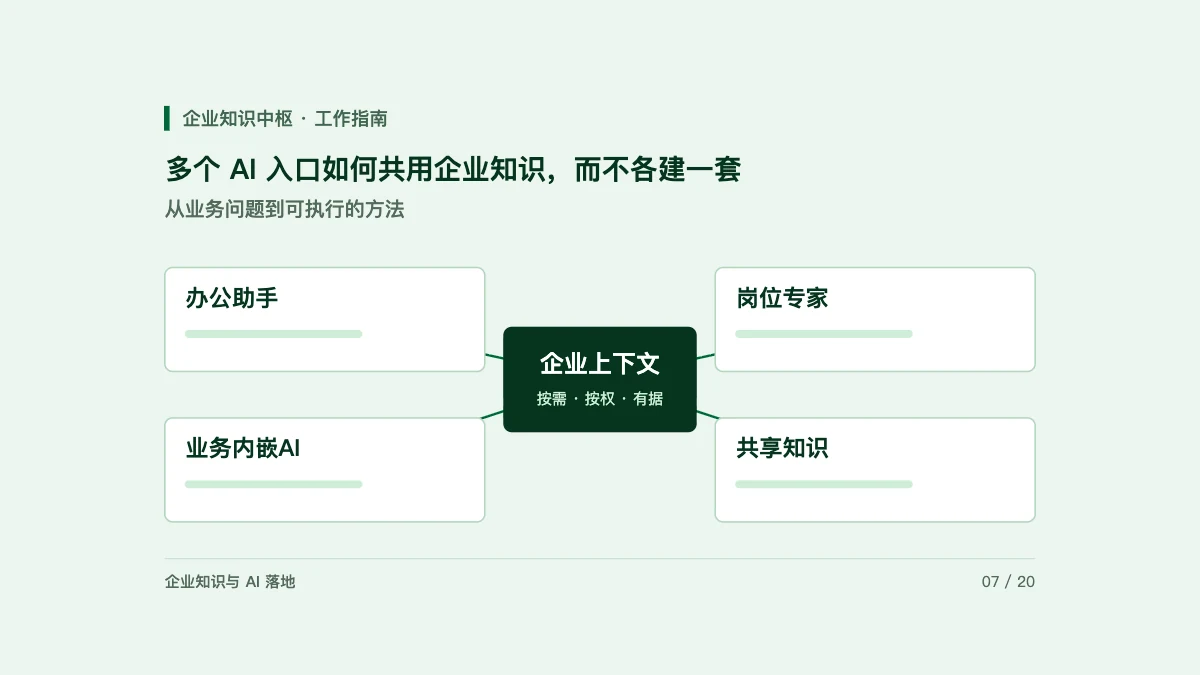
企业想让 AI 理解公司,又不希望内部信息无差别公开。一个容易执行的起点,是把员工日常工作需要的知识与管理范围内的知识分开维护,并为两者制定明确的内容规则。
“员工库”和“管理库”是知识共享边界的组织方式,不代表所有企业只能有两个权限级别。存在跨项目隔离或特定资料限制时,还应按实际业务保留更细的访问控制。
先按用途判断,再按文件位置处理
产品说明、获批准的工作流程、对岗位公开的协作规则,通常适合进入相应员工范围。管理讨论、尚未公布的组织安排和受限事项,应保留在获授权的管理范围。具体范围由企业明确,不能让模型自行推断哪些金额或岗位信息“应该保密”。
例如,销售报价规则可能对全体销售公开,而某次管理会议中混有人员安排。同一份原始纪要需要按内容分别处理,不能因为存在一段可共享规则,就把整份纪要变成员工可检索材料。
原文与共享知识不必一一对应
一份受限原文可以支持生成一段经过授权的通用规则。共享页只保留员工完成工作所需的内容,删除与该用途无关的身份、讨论和私人信息;引用则指向员工能访问的正式规则或已发布依据。
这项处理不能只靠把姓名换成字母。上下文、事件细节、项目组合甚至文件标题,仍可能暴露不应共享的信息。应从读者实际能看到什么来审查,包含正文、摘要、目录、链接文字和附件。
两个库的维护关系要明确
| 工作 | 负责角色 | 必须留下的依据 |
|---|---|---|
| 定义共享范围 | 企业授权负责人 | 内容分类和岗位范围 |
| 整理候选内容 | 知识维护人员或整理 Agent | 原始来源与修改说明 |
| 从管理范围发布到员工范围 | 有权批准的负责人 | 发布决定与适用范围 |
| 日常知识使用 | 获授权员工及其 Agent | 当前身份与允许访问的内容 |
| 发现越界或错误 | 知识维护负责人 | 纠正记录与受影响页面 |
日常消费知识的 Agent 不宜因为一次对话中的要求,直接把管理内容写入员工库。发布动作应经过明确的管理路径。这样知识纠错、范围调整和撤回也能集中处理。
检索结果本身也会泄露信息
只有点击文档时才检查权限,仍然可能太晚。受限项目的标题、人员名单、命中片段或“存在某份材料”的提示,都可能让没有权限的人得到信息。检索、目录、推荐、引用和导出应使用一致的访问范围。
同样不能先把全部原文给模型,再要求它“不要说出来”。更稳妥的实现是先按身份限制可读取的数据,再在输出阶段检查摘要和引用。模型提示语有帮助,但不能替代服务端的数据权限。
共享范围变化后,检查派生内容
某份资料撤回或访问范围调整时,原文件、搜索索引、知识摘要和对外导出是否跟随变化,需要有清楚的处理路径。只撤回原文件却保留能够还原内容的摘要,会造成边界不一致。
这里的重点是建立企业自己的发布与纠错流程,不是把知识维护变成繁琐的审批系统。常规员工知识可按已批准规则直接整理;跨越既有共享边界时,再由有权的人确认。
用两个身份核验同一道问题
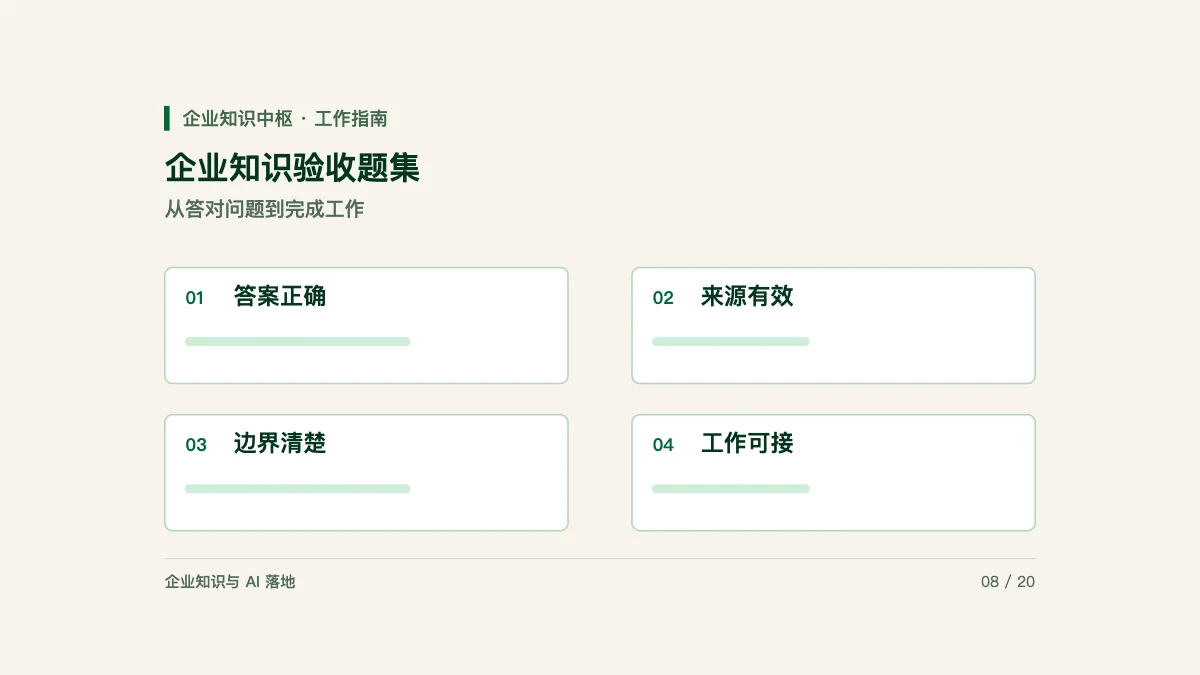
选取同时涉及公开工作规则和受限事项的问题,让员工身份与管理身份分别查询。员工应能完成自己的工作,管理身份能读取其授权范围,两者都能说明依据。检查时不仅看最终回答,也要查看命中文档、引用链接和下载内容。
可配合群聊与会议知识整理建立发布前处理方式,再用任务型验收题集验证。知识服务整体说明见企业知识中枢。
更多同主题内容见企业 AI Agent 落地专题。